Kompresija podataka

Kompresija podataka se bavi predstavljanjem informacija u kompaktnom (skraćenom) obliku. Tehnike kompresije podataka se koriste u velikom broju aplikacija i često se kompresija podataka odvija potpuno bez znanja korisnika.
Na primjer, 24-bitni video rezolucije 640x480 piksela, uz 30 fps (frames per second) zauzima 27,6 MB za svaku sekundu videa, a jedan sat videa bi zauzeo 99,5 GB na uređaju za pohranu. To znači da bi se na disk veličine 320 GB moglo smjestiti samo oko tri sata videa (otprilike dva filma uobičajenog trajanja). Uz korištenje adekvatnog postupka kompresije se bitno umanjuju zahtjevi u vezi pohrane podtaka, tako da savremeni standardi omogućavaju da se na disku ove veličine smjesti daleko više sati videa.
Problem kompresije podataka uključuje pronalaženje efikasnog algoritma za uklanjanje raznih redundantnosti iz određene vrste podatak, odnosno kako se za neki niz znakova s može odrediti alternativni niz znakova, koji zauzima manje prostora za pohranu. Postignuto umanjenje ovisi o algoritmu, kao i o redundanciji prisutnoj u originalnim podacima.
Kompresija podataka se može posmatrati kao postupak efikasnog predstavljanja digitalnih izvora podataka, kao što su:
- tekst,
- slike,
- zvuk,
- video,
- kombinacija pomenutih.
Cilj postupka kompresije podataka je predstavljanje podataka u digitalnom obliku sa što manje bita, pri čemu su ispunjeni minimalni zahtjevi vezani uz rekonstrukciju originala. Iza svakog konkretnog algoritma za kompresiju podataka stoje ideje, matematički modeli i tehnike implementacije za postizanje određenog stepena kompresije.
Postupak kompresije i dekompresije podataka su predstavljeni na slici 1.
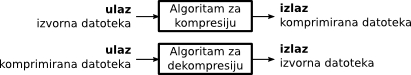
Kada se razmatraju osobine algoritma kompresije podataka, moramo uzeti u obzir i efikasnost algoritma, te učinkovitost kompresije.
Za bilo koji algoritam kompresije je potrebno da posjedujemo i odgovarajući algoritam za dekompresiju. U mnogim praktičnim slučajevima je učinkovitost algoritma za dekompresiju važnija nego učinkovitost algoritma za kompresiju. Na primjer, filmovi, slike i audio podaci se često komrpimiraju samo jednom pri kreiranju sadržaja, a ista verzija komprimirane datoteke se mnogo puta dekomprimira od strane korisnika.
Kompresija s gubicima i bez gubitaka
S obzirom na mogućnost rekonstrukcije originalnih podataka, sve tehnike kompresije se dijele na:
- kompresiju bez gubitaka,
- kompresiju sa gubicima.
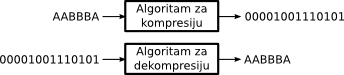
Kompresija podataka bez gubitaka (lossless compression) je način kompresije kod kojeg ne dolazi do gubitaka podataka i smanjenja kvaliteta informacija. Postupak je u potpunosti reverzibilan (slika 2), što znači da se dekompresijom komprimirane datoteke dobiju podaci koji potpuno odgovaraju onima sadržanim u originalnoj datoteci.
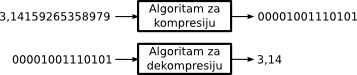
Kompresija podataka sa gubicima (lossy compression) ne može iz komprimirane datoteke u potpunosti rekonstruirati izvornu datoteku. Prilikom provođenja postupka kompresije se gube beznačajni detalji (slika 3), posmatrano sa stanovišta zahtjeva u pogledu kvalitete dekomprimiranih podataka.
Kompresija sa gubicima se još naziva i ireverzibilnom kompresijom.
Kodovi fiksne i promenljive dužine
Postoje dva tipa kodova:
- Kodovi fiksne dužine,
- Kodovi promjenljive dužine.
Kod kodova fiksne dužine su sve kodne riječi iste dužine. Za razliku od ovih kodova, kodovi promjenljive dužine koriste kodne riječi čija dužina varira. Ovi kodovi su poželjniji sa stanovišta kompresije podataka, obzirom da se smanjenje veličine datoteke može postići dodjeljivanjem kraćih kodnih riječi simbolima koji se često pojavljuju, a duže kodne riječi simbolima koji se rjeđe ponavljaju.
Prefiks kodovi
Kodovi promjenljive dužine su korisni za kompresiju podataka. Međutim, kodovi promjenljive dužine bi bili beskorisni da se kodne riječi ne mogu jedinstveno identificirati iz kodirane poruke. Da bi ovo bilo moguće, kod mora biti jedinstveno dekodabilan.
Kod je jedinstveno dekodabilan ako postoji samo jedan način da se dekodira poruka.
Najefikasniji jedinstveno dekodabilni kodovi su prefiks kodovi, odnosno kodovi čija ni jedna kodna riječ ne predstavlja prvi dio (prefiks) neke druge kodne riječi.
Optimalni kodovi
Teorija informacija može reći koliko je neki prefiks kod uspješan sa stanovišta kompresije podataka. Za mjeru efikasnosti koda se koristi odnos entropije izvora i prosječne dužine kodne riječi:
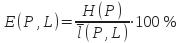
gdje je entropija:
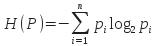
i prosječna dužina kodne riječi:
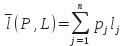
Kod je optimalan ako efikasnost koda dosegne 100%, odnosno kada je prosječna dužina kodne riječi jednaka entropiji izvora. Međutim, zbog više razloga ni jedan kod ne može dosegnuti ovu vrijednost efikasnosti, ali je postupak kodiranja bolji što je efikasnost bliža teorijski optimalnoj.
Algoritmi za kompresiju
Cilj korištenja algoritma za kompresiju je da izvornu poruku predstavi sa što je moguće manje bita i da omogući pretvaranje tog skraćenog prikaza poruke nazad u izvornu poruku. U suštini, sve metode kompresije uključuju dva koraka:
- modeliranje
- kodiranje
Model predstavlja znanje o domeni izvorne poruke i manipulaciju redundancije izvorne poruke. Ovisno o tome da li se model može ažurirati tokom kompresije odnosno dekompresije, razlikujemo dva tipa algoritama:
- statički algoritmi – model koji se koristi ostaje nepromijenjen tokom provođenja procesa kompresije/dekompresije
- adaptivni – model se može mijenjati na osnovu ulaza tokom provođenja procea kompresije/dekompresije.
