Algoritmi za kompresiju slike

U nastavku će biti predstavljeni najčešće korišteni algoritmi za kompresiju slike.
Run-length encoding (RLE)
Ovaj tip algoritma za kompresiju se koristi za podatke čiji simboli imaju tendenciju da oblikuju ponavljajuće grupe. Tada, umjesto kodiranja svakog simbola u grupi individualno, možemo koristiti pristup da kodiramo jedan simbol i dužinu dotične grupe. Kako bi bolje razumjeli rad ovog algoritma, analiziraćemo nekoliko primjera.
Pogledajmo stringove:
- KKKKKKKKK – imamo ponavljanje simbola K devet puta
- ABCDEFG – nema ponavljanja simbola u stringu
- ABABBBC – simbol B se ponavlja tri puta
- Abc123bbbbCDE – simbol b se ponavlja četiri puta
Run-length algoritam koristi triplet (r, l, s) kako bi zamijenio ponavljajuće grupe simbola. Triplet (r, l, s) se sastoji od sljedećih elemenata:
- r – run-flag, koji označava ponavljajući simbol,
- l – broj ponavljanja simbola,
- s – simbol iz alfabeta koji se ponavlja.
Korištenjem ovog pristupa string KKKKKKKKK iz primjera 1 bi kodirali kao (“r”, 9, “K”), ili skraćeno r9K. Kada nema ponavljanja, koristimo triplet oblika (n, l, s), gdje su:
- r - run-flag koji naznačava neponavljajuće simbole,
- l – broj neponavljajućih simbola,
- s – string koji sadrži neponavljajuće simbole.
Korištenjem ovog pristupa će string ABCDEFG biti kodiran kao (“n”, 7, “ABCDEFG”).
Algoritam za RLE kompresiju
Algoritam RLE kompresije se odvija prema sljedećoj proceduri:
čitaj simbole ulazne datoteke sekvencijalno sve do kraja datotekeako se pojavljuje niz od i (i=2, 3, ..., 127) ponavljajućih simbola, ispiši r, broj ponavljanja i ponavljajući simbol;u suprotnom identificiraj najdući niz od i (i=2, 3, ..., 127) neponavljajućih simbola, ispiši r, dužinu stringa i string.
Entropijsko kodiranje
Pošto entropija ukazuje na informacijski sadržaj nekog izvora, ona omogućuje dizajniranje metoda kodiranja koje se nazivaju entropijske metode.
Od entropijskih metoda kodiranja, najjednostavnije su:
- Huffmanovo kodiranje,
- Shannon-Fano kodiranje,
- Adaptivno Huffmanovo kodiranje.
Huffmanovo kodiranje
Ovaj metod kompresije je razvio David A. Huffman 1952. godine. Huffmanovo kodiranje je prvobitno bilo korišteno za kompresiju teksta. Huffman je primjetio da se u bilo kojem tekstu neka slova ponavljaju češće od drugih. Na primjer, u našem jeziku se slova a, e, i, o, u pojavljuju dosta češće od slova kao što su z, f, ž. Huffmanova ideja je bila da se za predstavljanje simbola, umjesto kodnih riječi fiksne dužine, koriste kodne riječi promjenljive dužine. Pri tome se kraće kodne riječi koriste za slova koja se češće ponavljaju, a duže kodne riječi za slova koja se rjeđe ponavljaju. Na ovaj način je smanjen ukupan broj bita potreban za predstavljanje nekog teksta.
Na primjer, posmatrajmo string BILL BEATS BEN. Frekvencija pojavljivanja simbola u ovom stringu je:
| B | I | L | E | A | T | S | N |
| 3 | 1 | 2 | 2 | 1 | 1 | 1 | 1 |
Sortirana lista po opadajućim frekvencijama je:
| B | L | E | I | A | T | S | N |
| 3 | 2 | 2 | 1 | 1 | 1 | 1 | 1 |
Izvorna poruka se sastoji od simbola iz alfabeta (B, L, E, I , A, T, S, N) sa frekvencijama pojavljivanja (3, 2, 1, 1, 1, 1, 1). Svakom simbolu iz alfabeta je potrebno dodijeliti kodnu riječ sa prefiks svojstvom.
Algoritam Huffmanovog kodiranja
Ulaz u ovaj algoritam je string simbola, a izlaz iz algoritma je binarna datoteka (niz jedinica i nula). Algoritam se sastoji od podproblema:
čitaj ulaznu datotekuderiviraj prefiks kodza svaki simbol ispiši kodnu riječ
Prvi i zadnji podproblem su jednostavni za rješavanje. Radi toga će u nastavku kratko biti predstavljen pristup rješavanju drugog podproblema. Rješavanje ovog podproblema se bazira na gradnji binarnog stabla od listova (simboli) prema korjenu.
Proces gradnje binarnog stabla se odvija prema proceduri (slika 4):
staviti sve simbole u listu sortiranu prema opadajućim frekvencijamaponavljati sve dok lista ne bude imala samo jedan simbol:pronaći dva čvora sa najnižom frekvencijom, dodijeliti im oznake i objediniti ih u čvor binarnog stablapridružiti sumu frekvencija čvorova koji su objedinjeni novom čvoruobjedinjene čvorove obrisati iz listepridružiti svakom listu binarnog stabla kodnu riječ koja se formira na temelju putanje od korjena stabla do lista.
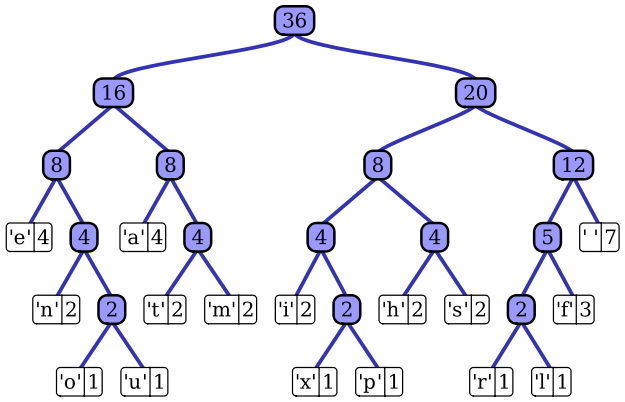
Proces dekodiranja (dekompresije) je vrlo jednostavan. Prilikom dekodiranja se koristi prethodno izgrađeno binarno stablo, tako što čitamo kodiranu poruku bit po bit, pri čemu se počevši od korjena spuštamo duž grana određenih bitima, sve dok ne dođemo do lista. List određuje dekodirani simbol.
Shannon-Fano kodiranje
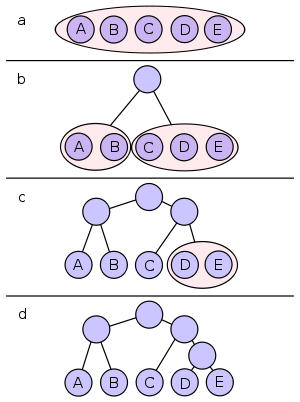
Shannon-Fano algoritam su neovisno razvili Claud Shannon (Bell Labs) i Robert Fano (MIT). Shannon Fano kodiranje je vrlo slično Huffmanovom kodiranju, a razlikuju se samo po načinu formiranja binarnog stabla. Dok Huffmanov algoritam koristi Bottom-up pristup, Shannon-Fano algoritam koristi top-down pristup, odnosno binarno drvo se formira od korjena prema listovima.
Procedura ovog algoritma je:
sortirati simbole po opadajućoj frekvenciji njihovog pojavljivanjarekurzivno dijeliti simbole u dva dijela približno istih frekvencija, pri čemu svakom dijelu dodjeljivati oznakudijeljenje nastaviti sve dok svaka grupa ne bude sadržavala samo jedan simbol.
Procedura Shannon-Fano kodiranja je ilustrirana na slici 5.
Adaptivno Huffmanovo kodiranje
Huffmanov algoritam zahtijeva prethodno statističko znanje o informacijskom izvoru, što nije uvijek na raspolaganju. To se prije svega odnosi na multimedijalne aplikacije, kod kojih su budući podaci nepoznati sve do njihovog prijema. Rješenje u ovom slučaju je korištenje adaptivnih algoritama kompresije. Kod tih algoritama se statistika prikuplja i dinamički mijenja sa prijemom novih podataka. Vjerovatnoće nisu zasnovane na nekom prethodnom znanju, nego na stvarnim podacima primljenim do nekog trenutka. Ovakve metode se nazivaju adaptivnim zato što se simbolima daju nove kodne riječi (duže ili kraće) kako se distribucija vjerovatnoća primljenih simbola mijenja. Ovo je vrlo važno za multimedijalne podatke, obzirom da se sadržaj (boja, scene i sl.), a time i statistika mogu značajno promijeniti prijemom novih podataka.
Adaptivno Huffmanovo kodiranje predstavlja tehniku razvijenu na temelju statičkog Huffmanovog kodiranja (Newton Faller, poboljšano od strane Donalda Knutha i Jefreya S. Vittera). Mnoge ideje iz ovog algoritma se koriste i kod drugih adaptivnih algoritama kompresije.
Adaptivni Huffmanov algoritam za kodiranje poboljšava omjer kompresije upotrebom modela čija se statistika temelji na izvoru iz neposrene prošlosti. Alfabet i njegova tabela frekvencija se dinamički podešavaju nakon čitanja svakog simbola u procesu kompresije i dekompresije. U usporedbi s statičkim Huffmanovim kodiranjem, adaptivni model je puno bliži stvarnom stanju izvora nakon početnih koraka. Alfabet i frekvencije svakog do simbola se prikupljaju i održavaju dinamički u svakoj iteraciji. Huffmanovo stablo se pri tome dinamički ažurira na temelju alfabeta i frekvencija. Kada se enkoder i dkoder nalaze na različitim lokacijama, svaki održava identično Huffmanovo stablo za svaki korak samostalno. Prema tome, kod adaptivnog Huffmanovog kodiranja ne postoji potreba za prenošenjem Huffmanovog stabla.
LZW kodiranje
Abraham Lempel i Jacob Ziv su 1977. udarili temelje novom velikom koraku u kompresiji podataka. I pored toga što je Huffmanov koder postizao dobre rezultat, tipično je bio limitiran na kodiranje po jednog karaktera u jednoj vremenskoj jedinici. Lempel i Ziv su predložili šemu koja bi enkodirala nizove podataka. Ova tehnika je uzela maha zbog njenih prednosti pri kodiranju sekvenci koje se često pojavljuju, kao što je npr. tačka popraćena jednim razmakom u tekstualnim datotekama. LZW (Lempel-Ziv-Welch) algoritam je prezentiran u doktorskoj disertaciji Terryja Welcha 1984. godine. Ovaj algoritam omogućava kreiranje kodne tabele na isti način i za kompresor i za dekompresor, pri čemu ovu informaciju nije potrebno uklučiti u komprimirane podatke. Ovaj algoritam se koristi u ARC kompresoru, te za kompresiju slika u GIF formatu.
LZW algoritam
Iako su implementacije algoritma ponekad komplicirane, sam LZW algoritam je vrlo jednostavan. Osnovna ideja LZW kodiranja se sastoji u prepoznavanju najdužeg uzorka za svaki segment izvornog teksta, te kodiranju ovog uzorka preko indeksa u rječniku. Ako ne postoji podudaranje sa trenutnim segmentom u rječniku, segment će postati novi zapis u rječniku. Najčešća implementacija LZW algoritma koristi 12-bitne kodne riječi za predstavljanje 8-bitnih unesenih znakova. Nizovna tabela ima 4096 lokacija, s obzirom da je to broj unikatnih adresabilnih lokacija jednog 12-bitnog indeksa. Prvih 256 (0-255) lokacija su inicijalizirane za same karaktere. Kako se parsiraju nove kombinacije karaktera tokom kompresije, ovi nizovi se dodaju tabeli nizova (rječniku), na lkacijama od 256 do 4095.
LZW dekompresor kreira isti rječnik za vrijeme dekompresije. Počinje sa prvim 256. unosom iz tabele inicijalizirane na pojedinačne simbole. Rječnik se ažurira za svaki karakter pri unosu, osim prvog. Nakon što je karakter korištenjem rječnika proširen u njemu odgovarajući niz, posljednji karakter niza se dodaje prethodnom nizu. Ovaj novi niz se dodaje rječniku na istu lokaciju kao i u rječniku kompresije.
Jedna od prednosti LZW-a nad Huffmanovim algoritmom leži u tome što je on u mogućnosti da komprimira ulazni tok u jednom prolazu, i pri tome ne zahtijeva nikakve prethodne informacije o toku podataka. Tabela nizova se pravi u letu tokom kompresije i dekompresije. Još jedna od prednosti je njegova jednostavnost, koja dozvoljava brzo izvršavanje.
