Historijat OCR-a


1929. Gustav Tauschek je patentirao OCR u Njemačkoj, a nakon njega je to isto napravio Handel u SAD-u 1933. 1935. Tauscheku je odobren patent za njegovu metodu i u SAD-u.
Tauschekov uređaj je bio mehanički stroj koji je koristio predloške.
Fotodetektor je bio postavljen tako da kad su predložak i znak koji se trebalo  prepoznati  bili  u  točno  određenom  položaju  te  ih  svjetlost obasjavala ništa svijetla ne bi dolazilo do fotodetektora
Prvi komercijalni sistem je instaliran u Readers Digest 1955. Isti taj sistem je kasnije doniran Smithsonianu gdje je postavljen kao izložak.Drugi sistem su prodali Standard Oil Company iz Kalifornije koji se koristio za čitanje oznaka na kreditnim karticama. Velik broj sistema je naknadno prodan  drugim  naftnim  kompanijama.  Neki  od  ostalih  korisnika  IMR sistema kasnih 1950. su i Ohio Bell Telephone Company, ZrakoplovstvoSAD-a te IBM.
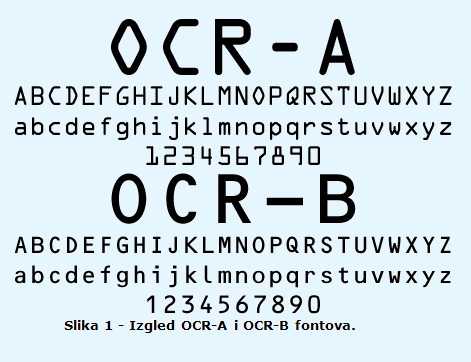
OCR-A, OCR-B
U početcima kompjuterskog OCR-a razvila se potreba za fontom koji će moći prepoznati tada spore kompjutere , ali koji će biti čitljiv i ljudima. Kao rezultat  tog  kompromisa  se  pojavio  OCR-A  font  koji  se  sastojao  od jednostavnih, debelih poteza koji su tvorili prepoznatljive znakove.1968. American Type Founders proizvodi OCR-A, jedan od prvih oblika znakova prilagođen za optičko prepoznavanje koji je zadovoljavao kriterije  ureda  za  standarde  SAD-a  (eng.  U.S.  Bureau  of  Standards).Dizajn  je tako  jednostavan da ga  je kompjuter mogao vrlo  lahko pročitati, tj.prepoznati, ali je nešto nezgodniji za čitanje ljudima. OCR-B je europski pandan tom fontu. Napravio ga je Adrian Frutiger iste godine. OCR-B font je lakši ljudima za čitanje od OCR-A fonta.
Postoje  besplatne,ali i komercijalne inačice ovih fontova koje prodaju različite kompanije. Iako je OCR tehnologija napredovala toliko da više nema potrebe za ovim specijaliziranim fontovima oni i dalje ostaju u upotrebi

historijat

Slika 1 - Izgled OCR-A i OCR-B fo ntova

Trenutno stanje OCR tehnologije


Tačno prepoznavanje isprintane latinice se smatra uglavnom riješenim problemom. Tipičan postotak tačnosti prepoznavanja prekoračuje 99% iako za određene aplikacije koje zahtijevaju još veću tačnost je potrebna ljudska intervencija i pregled grešaka. Ostala područja, poput prepoznavanja rukopisa, kurziva i načina pisanja različitog od latinice (posebno onih sa vrlo velikim brojem znakova) su i dalje predmet aktivnog istraživanja.

stanje

Slika 2 - Umjetnička vizualizacija OCR softwarea